
今回、6月25日・26日に幕張メッセで開催されたAWS Summit Japan 2026に、SREチームで参加してきました!
会場では多くの企業によるAWSの活用事例や、生成AI・セキュリティ・運用改善に関するセッションが行われており、日々の開発やSRE活動に活かせそうな学びが多くありました。
SREチームとしても、普段取り組んでいる信頼性向上や運用改善のヒントを得る良い機会になりました。
こちらのブログでは、弊社の参加メンバーが特に印象に残った講演について、自社の課題や活かせそうなポイントを踏まえて紹介します!
実践!Amazon RDS と Amazon Aurora のコスト最適化とパフォーマンス向上
「AWS Brand Event PPT Template_v1」1ページより引用
こんにちは!5月にクラシルへ入社しました、satsukiです 🌱 現在はクラシルのSREとしてインフラ運用や信頼性向上のための取り組みを行っています。
今年のAWS Summitは、ブレイクアウトセッションの約半数がAIエージェント関連でした。テーマも「何ができるか」より「本番でどう運用するか」を扱うものが目立っていて、各社が運用フェーズの課題に向き合い始めているんだなと肌で感じました。
一方で、やりたいことが増えるほど気になるのがコストです。新しい技術を試し続けるためにも、既存インフラのコストは常に見直しておきたいところです。 クラシルでもAuroraを運用しているのでコスト見直しのヒントになりそう💡と思い、こちらのセッションを聴講し、実際に多くの学びがありました。
セッションは、架空の企業が抱える7つの課題を、Database Insightsで現状を可視化→ボトルネックを特定→コンピュート・ストレージ・バックアップを適正化していく、という流れで解決する構成です。性能問題が起きるとインスタンス増強で対処しがちですが、垂直スケール以外の選択肢が次々と紹介されていて、コストとパフォーマンスは両立できると実感できる内容でした。
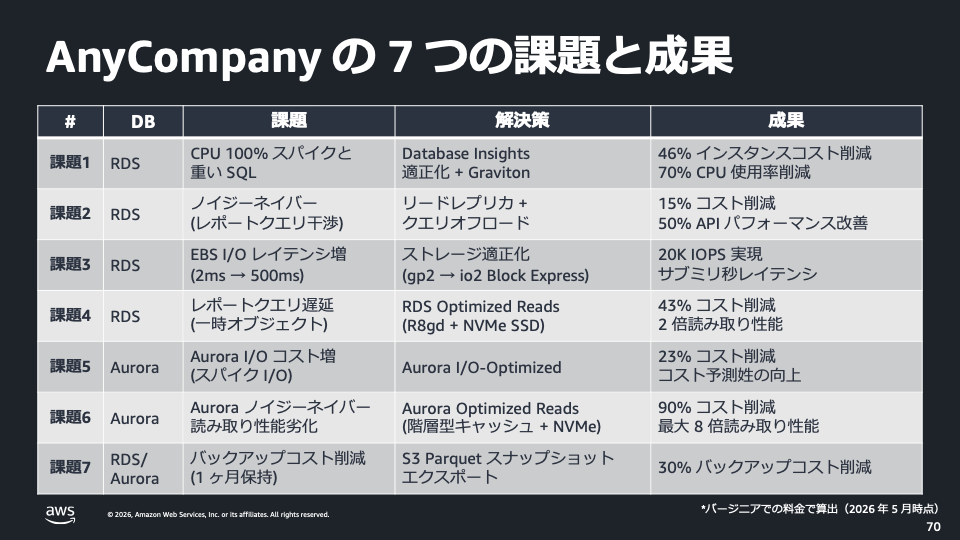 「AWS Brand Event PPT Template_v1」70ページより引用
Aurora I/O-Optimizedをクラシルに当てはめてみる
特に気になったのが、このセッションで初めて知ったAurora I/O-Optimizedです。I/Oリクエストへの課金がなくなる代わりにインスタンスとストレージの単価が上がる料金モデルで、I/Oの多いワークロードならコストを最大40%削減できるとのこと。夕食どきにトラフィックが跳ね上がるクラシルに合うかもしれないと思い、クラスタのメトリクスを確認してみました。
結果、I/O支出の割合は目安の25%を大きく下回っていました。読み取りのほとんどがバッファプール(メモリ上のキャッシュ)で完結していて、課金対象になるストレージ層へのI/Oが少なかったためです。切り替えは見送りましたが、メモリとI/O課金がトレードオフの関係にあると分かったのは収穫でした!バッファプールの余裕は、インスタンスサイズを検討するときの新しい判断材料になりそうです。
バックアップ要件を見直す
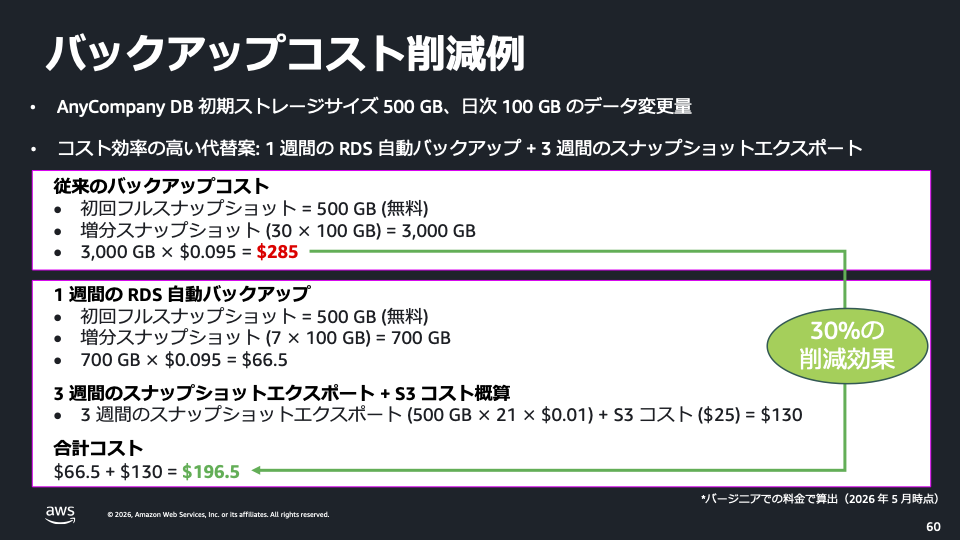
バックアップコストの削減では、保持期間を要件ごとに分けて考えるやり方が紹介されていました。
 「AWS Brand Event PPT Template_v1」60ページより引用
- データベースとして復元が必要なのは直近どの期間までかを決め、自動バックアップはその期間だけ保持する
- それより古いデータは監査などで参照できれば十分なことが多いので、スナップショットをParquet形式でS3へエクスポートする
クラシルのバックアップも、この軸で要件を整理し直せばさらにコストを下げられる余地がありそうです。 なお、弊社のバックアップ運用については、次のjoeさんのパートで詳しく紹介されています!
まとめ
コストの削減は、パフォーマンスをどこまで我慢するかという話になりがちです。でも今回紹介された解決策はどれも、現状を可視化して選択肢を知ってさえいれば、性能を落とさずにコストを下げられるものでした。クラシルには、トレードオフを前提にせず両方を成立させる道を探しにいく「Trade on」というバリューがあります。データベース運用でトレードオンするための引き出しが、今回のセッションでぐっと増えました。
他にもRDS・Auroraのコスト削減事例が紹介されているので、気になる方はぜひセッションの資料を見てみてください!
ランサムウェアに対して最優先で取るべき AWSの復旧対策
「R01_0625_STG205_v2.pdf」1ページより引用
SREチームのjoeです!AWS Summitの現地参加は久しぶりだったのですが、相変わらずの規模の大きさでとても楽しかったです!
私が紹介するセッションは、ランサムウェアに対して最優先で取るべき AWSの復旧対策です。
近年、ランサムウェアをはじめとするサイバー攻撃において、Backupデータそのものが標的になるケースが増えています。本番データを暗号化するだけでなく、復旧手段であるBackupも同時に破壊・暗号化することで、身代金の支払いを強制する手口です。
こうした攻撃に対して、単純なスナップショット取得だけでは防御として不十分です。こちらの講演は、AWS Backupがそのソリューションに最適である、という話となっています!
実際弊社としてもこちらの課題を抱えており、去年AWS Backupを導入しました。
弊社はAWSのマルチアカウント環境であり、開発チームがそれぞれBackupを運用している場合、取得頻度や保持期間にムラが出やすく、いざというときに復元できないリスクもありました。実際にPRC(Production Readiness Check)を運用する中で、Backupは負荷の高い項目でした。その課題に対してOrganization単位でAWS Backupを導入しました。Organization側で、AWS Backupを実装することで、各AWSアカウント側はリソースタグ付けのみで3-2-1-1-0ルールを踏襲したバックアップが取得できるようになりました。実際に入れてみてとてもいいソリューションで、運用工数も大幅に下がりました。
ただしいくつかハマりポイントがあったのでこちらの講演を見てAWS Backupを導入する方は参考にしてみてください!
AWS Backupで実際に体験したハマりポイント
コストについて
1. DynamoDB
弊社のDynamoDBのテーブルサイズが大きく、数TBあるテーブルではBackupコストが想定を大幅に上回りました。
S3は増分Backupに対応していますが、DynamoDBのAWS Backupは増分Backupに対応していません。毎日フルBackupを取得すると莫大なコストがかかります。
対策として、巨大なテーブルに対しては以下の構成にしています。
- AWS BackupによるDynamoDBの取得は月1回に抑制
- S3にはPITR(Point-in-Time Recovery)を有効化し、S3をBackup対象にする
- 復元時には、日次の差分をGlueジョブでPITRの情報からテーブルに補填する仕組みを構築
これによりBackupコストを大幅に抑えつつ、復元時のデータロスを許容範囲に収めています。
2. S3
S3は増分Backupに対応しているものの、RequestTier2(データ取得リクエスト)のコストが想定以上にかかりました。オブジェクト数が多い場合は、Backupコストの見積もり時にリクエスト料金も含めて試算することをおすすめします。
PolicyとVaultの切り分け方について
AWS BackupにはPolicyとVaultという概念があります。
- Policy: バックアップを「どう取るか」を決めるルール(スケジュール・保持期間・保存先)
- Vault: 取ったバックアップを「どこに置くか」となる保管庫(暗号化・アクセス制御の単位)
両者は設計の自由度が高い分、PolicyとVaultをどういう単位で分けるかで迷いました。これはいち意見なので、正解ではありませんが、個人の意見を載せておきます。
1. Policyの切り分け
結論として、Backupの要件(重要度)ごとに分けるのが運用しやすいと考えます。例えば「重要度 高・中・低」のような分類です。
また、Policyの命名規則ですが、要件の意味(重要度)で命名し、具体的な設定値はPolicy定義の中に閉じ込めるほうが安全だと思っています。 例えば daily-30days-retention のような命名にすると、途中からBackup要件を変更したくなったとき、Policy名やタグと実態がズレてしまいます。
2. Vaultの切り分け
コンプライアンスモードの有無や保持期間の違いで分けるのが一般的なのかなと思いますが、運用してみて復元設定を変えたい単位で分けるパターンもあると感じました。復元の設定はVault単位一括でしか行えないためです。
逆にそれ以外の軸で細かく分ける必要はないと考えています。弊社のパターンでは、Vaultを統一しておけばアカウントが増えてもVaultを追加する必要がなく、運用が楽になりました。
ECS 最新デプロイパターン Deep Dive
SREのmoikeiです! 弊社はほぼ全サービスでECS/Fargateを利用しており、デプロイも多いです。 こちらのセッションではECSのデプロイ周りに関して直近のアップデートを扱うセッションでした。大きく2点です。
- 高解像度メトリクスによるスケールアウト: 高解像度メトリクス(20秒粒度)を使ったスケーリング
- Seekable OCI (SOCI) v2: コンテナイメージの遅延読み込みによる起動高速化。
特に2はFargateも2025年7月に対応したこともあり、弊社に全体的に活用できそうと感じました。使用感を確認してみましたので、参考にしてください!
サクッと試してみた
SOCIとは、コンテナイメージを全部ダウンロードし終わってから起動するのではなく、必要なファイルだけ先に取り出してコンテナを起動できるようにする仕組みです(レイジーローディング)。
ECRのイメージをローカルにダウンロードしイメージ変換後、再プッシュしてECS起動し、どのくらい早くなるかみてみました。イメージサイズが小さいと効果が出ないとのことで、458MBのイメージでやってみました。
必要なものは以下です。
- レジストリ/OCI layout操作系: ECRからイメージを取り出し、変換後のイメージをECRへ戻すために使用。ローカル(Mac)で動作確認したかったため今回は
craneを使用。 - SOCI専用ツール:
soci convertを使用。SOCI v2のSOCI-enabled imageを生成する
こんな手順でやってみました。
今使っているイメージをECRから手元のOCI image layoutとして取り出す
crane pull --format=oci <ECR_REPO>:<TAG> image-ocisoci convertで、元イメージのレイヤーとSOCI indexを紐付けたSOCI-enabled imageを生成する# 今回はMac上でサクッと確認したかったため、Linux/arm64のコンテナ内で soci を実行しました。soci バイナリは事前にローカルへダウンロードし、作業ディレクトリに置いています。 docker run --rm --platform linux/arm64 \ -v "$(pwd)":/work \ -w /work \ alpine:3.20 \ /work/soci convert --standalone --format oci-dir /work/image-oci /work/image-soci変換後のイメージを、別タグでECRへpushする
crane push image-soci <ECR_REPO>:<TAG>-sociECSタスク起動
ECRを見ると、以下の3つが確認できました。
| Type | サイズ | 役割 |
|---|---|---|
| Image | 458.53MB | コンテナイメージ本体 |
| Soci Index | 21.23MB | レイヤー内のファイル位置など、遅延読み込みに使う索引 |
| Image Index(tag付き) | 458.53MB | ECS/Fargateのタスク定義から指定するSOCI-enabled image |
ECRコンソール上では、tagなしのImage Indexなど追加の行が見えることもありますが、SOCI v2として理解するうえでは、元イメージ本体・SOCI index・それらを紐付けるImage Indexの3つを見ると分かりやすいです。
結果どうだったか?
| pull時間 | 全体起動時間 | |
|---|---|---|
| Before(通常イメージ) | 約13.6秒 | 約30.1秒 |
| After(SOCI v2) | 約3.9秒 | 約19.6秒 |
pull時間 約71%減、全体起動時間 約35%減 となりました!
デプロイやスケール時にも高速に完了できそうです。デプロイプロセスへ組み込みも検討しようと思います!
AWS における Kubernetes の未来
レシチャレのSREチームに所属しているKJです。弊社はほぼ全サービスで ECS/Fargate を利用していますが、最近 AI 基盤やプラットフォーム化の流れで EKS / Kubernetes を採用するケースが増えてきた感覚があり、動向を掴んでおきたくてこのセッションを聞いてみました。ECS ユーザー目線でも「これはいいな」と思えた点が多かったので、まとめておきます。
一番の学び:EKS と ECS の選択基準
個人的に一番の学びだったのが、EKS と ECS の選択基準の話です。「Kubernetes のエコシステム(周辺の OSS ツール群)をそのまま使いたい」というニーズが採用理由になる、というのは、ECS 中心でやってきた自分には新鮮な視点でした。セッションでも 「Kubernetes API とエコシステムのツールは使いたい。しかし、クラスターやアップグレードのことは考えたくない」 という声が紹介されていて、まさにこの需要を言い当てているなと感じました。こうした背景もあって採用が増えているのかもしれません。
ECS ユーザーとして「いいな」と思った点
- EKS もメンテナンスフリーの方向に進んでいる:アップグレードやノード管理を AWS 側にオフロードする流れ(Auto Mode、アップグレードインサイト、アップグレード前提の AWS Backup 対応など)が印象的でした。Kubernetes は採用したはいいものの、その後のアップデートライフサイクルに追従し続けるのが辛い、という話は現場でもよく耳にします。だからこそ「運用をなるべく AWS 側で引き受ける」方向への進化は、素直にありがたいなと感じました。
- グローバルダッシュボードが便利そう:AWS Organizations からワンクリックで、全アカウント・全クラスターのインベントリやバージョンをまとめて俯瞰できます。これは Kubernetes に限った話ではなく、マルチアカウントで運用していると複数アカウントをまとめて見たい場面が多いので、こうした横断ビューは素直に便利そうだと感じました。
- ロードマップは引き続き注視したい:セッションで案内された公開ロードマップ(github.com/aws/containers-roadmap)には、EKS だけでなく ECS の情報も載っています。たとえば ECS Service Connect の Zone-Aware ルーティングは、ちょうど 2026 年 7 月に GA になったばかりの機能で、同一 AZ 内のサービス間通信を優先することで AZ 間(cross-zone)のデータ転送を削減できます。デフォルト有効(既存サービスは一度再デプロイすれば有効化)とのこと。ある程度トラフィックのあるシステムだと AZ 間のデータ転送コストも無視できない規模になってくるので、コスト面でかなり効いてきそうです!
EKS の進化の方向性は、ECS のこれからを考えるうえでも参考になります。引き続きロードマップは追いかけていきたいと思います。
参考にしたURL - aws/containers-roadmap(GitHub)
AWS DevOps Agentによる自律的インシデント対応 - その能力を引き出す設計のベストプラクティス
SREチームのkaitoです!
弊社ではすでにDevOps Agentを導入していますが、まだ活用しきれていない部分もあります。インシデント対応での初動の遅さや、各種ダッシュボードの行き来で調査速度に課題を感じていたため、一次対応時にすでにエージェントによる調査結果が出力され、初動の速度が上がることを期待してこのセッションを聴きました。
セッションの概要
DevOps Agentは「調査はAI、判断は人」をコンセプトにした障害対応特化のAIエージェントです。アラートをトリガーに自律的に調査を開始し、メトリクス・CloudTrail・ログを収集して根本原因を特定、緩和計画の提案まで行います。セッションではデモに加え、DevOps Agentの能力を引き出すベストプラクティスが紹介されていました。
能力を引き出す設計のベストプラクティス
- 調査スコープを決めて精度を引き出す:DevOps AgentにはAgent Spaceという概念があります。標準ではアカウント単位ですが、マルチアカウントで同一システムを構成している場合はシステム単位でまとめないと、別アカウントの変更が調査対象に入らず根本原因を特定できません。逆に同一アカウント内でも、stg/prdでAgent Spaceを分けて本番環境の調査にステージングのリソースが混入しないようにする設計も可能です。弊社もマルチアカウント構成なので、この設計方針はそのまま使えそうです。
- テレメトリを充実させて正確性を上げる:デモでは、あるサービスのアプリケーションログがインシデント時間帯に存在せず原因特定できないケースが紹介されていました。Container/Database/Lambda InsightsでAWSマネージドサービスを観測し、OpenTelemetry(AWS Distro for OpenTelemetry)でアプリケーション側の情報を取得できるようにしておくことで、調査の精度を上げる例が発表されていました。
- ナレッジを共有して時間を短縮する:同じ障害シナリオでナレッジ整備前後を比較したデモでは、根本原因に到達するまでの時間が6分32秒から3分38秒に短縮されていました。個別の調査手順はSkills、共通の前提知識はAgent Instructions(AGENTS.md)で渡すことが推奨されていました。既存のRunbookをmarkdownやPDF、画像からそのまま取り込めるので、導入のハードルは低そうでした。障害対応のナレッジは属人化しがちですが、「人に教える」のではなく「エージェントに教える」ことでチーム全体の調査品質を底上げできるという考え方が面白かったです。
応用:MCPサーバーによる拡張
ビルトイン連携(CloudWatch、New Relic、GitHub)等に加え、MCPサーバー経由で社内の独自ツールとも接続できます。紹介された事例では、AWS上で構築されたMCPサーバーを利用し、DBの中身まで安全に調査する拡張が紹介されていました。(CyberAgent社)
全体的に実用性の高い内容のセッションでした!既存の構成をベストプラクティスに寄せながら、属人化しないインシデント対応を目指していきたいと思います!
まとめ
以上がクラシル社のSREチームが気になった講演と、自社のシステムを踏まえたうえでポイントに感じたこととなります。 引き続きAWSを利用し、スピード感を持ってユーザーに価値貢献できればと思います!
